サイト内検索が日本語だけ当たらない——索引の切り方(トークナイザ)を疑う
記事が増えたのにサイト内検索が当たらない。原因は本文を索引にするときの区切り方で、既定は英語向けです。SQLite FTS5のトークナイザをtrigramに替えると日本語の途中一致を拾える。2文字以下が落ちる穴と、UIでの吸収まで実測つきで。
記事が52本になったところで、サイト内検索の効きを確かめようと思った。検索APIに「データが更新」と入れたら、返ってきたのは0件。
この6文字は、公開中の記事タイトル「構造化データが更新で壊れるCMSを、壊れない運用設計にする」にそのまま入っている。索引は張られている(/_emdash/api/search/stats は blog_posts 52件と返す)。記事も公開済み。それでも0件でした。
犯人は記事でも索引の張り忘れでもなく、本文をどこで切って索引にするかという設定です。ここを既定のまま日本語サイトに検索を付けると、「たまに当たるけれど、たいてい当たらない」検索ができあがります。
「検索が当たらない」の正体は、文を切る場所
全文検索は、本文を単語(トークン)に切ってから索引を作ります。英語なら簡単で、スペースが区切りになる。contact form は contact と form の2語。
日本語にはその区切りがない。「お問い合わせフォームのスパムを減らす」には空白も記号もないので、切れ目が見つからないまま、ひとかたまりで索引に入ります。
自サイト(EmDash・公開52本・トークナイザは既定のまま)で、同じ検索APIに投げた結果です。
- 「構造化」→ 6件。当たる
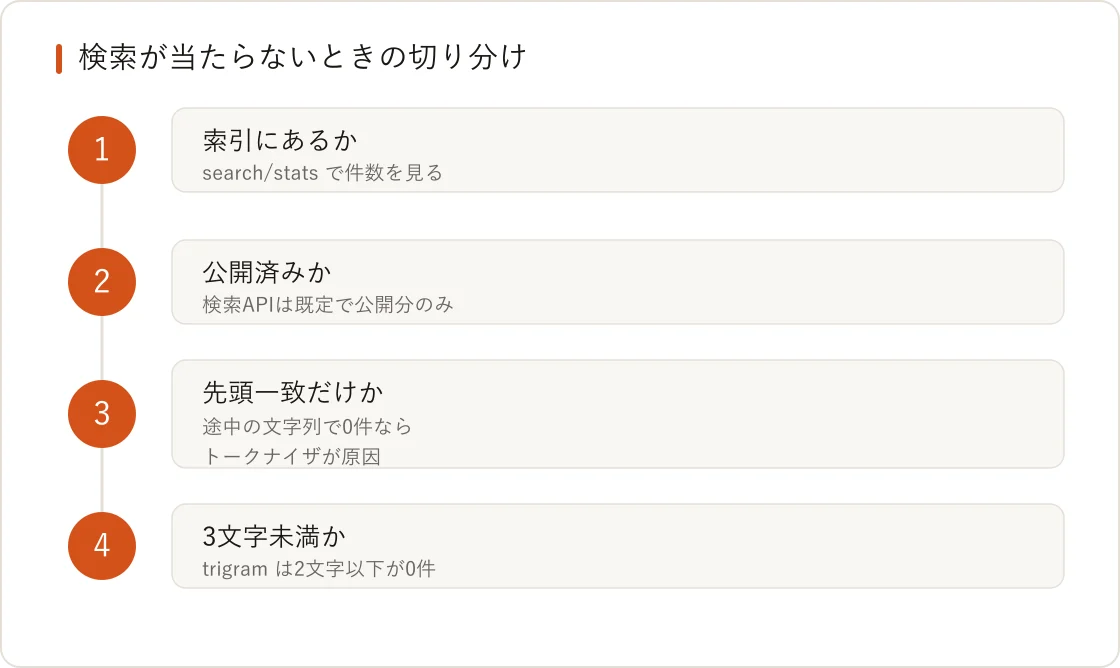
- 「データが更新」→ 0件
- 「フォーム」→ 14件。当たる
- 「わせフォーム」→ 0件
当たった2つは、かたまりの先頭から始まる文字列。落ちた2つは、途中から始まる文字列。どちらも記事タイトルにそのまま含まれている点は変わりません。
読者が検索窓に打ち込むのは、たいてい途中の言葉です。「フォーム」と過不足なく打ってくれる人ばかりではない。この状態の検索窓は、置いてあるだけで実質は機能していません。
直し方は、切り方(トークナイザ)を替えること
SQLite の全文検索(FTS5)を土台にしたCMSなら、この切り方=トークナイザを選べます。自サイトも Cloudflare D1(中身はSQLite)で動かしています(EmDashをCloudflareにデプロイする)。
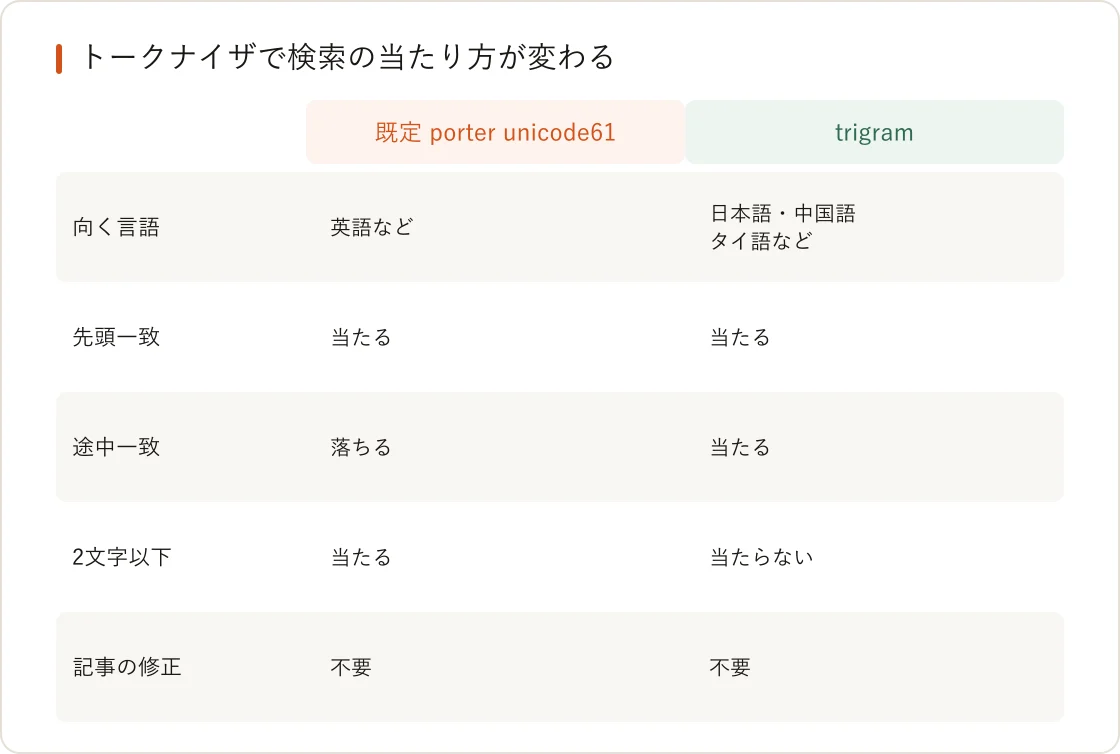
EmDash の既定は porter unicode61。英語の語形変化を吸収する(correction と corrected を同じ語として扱う)Porterステミング付きで、名前のとおり英語向けです。
日本語には trigram を指定する。3文字ずつ、1文字ずらしながら索引を作る方式なので、文の途中からの一致を拾えます。EmDash の公式ドキュメントも、日本語・中国語・タイ語のように語を空白で区切らない言語には trigram を挙げている。
切り替えはコレクション単位で、APIを1回叩くだけ。
curl -X POST https://example.com/_emdash/api/search/enable \
  -H "Authorization: Bearer $EMDASH_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"collection":"blog_posts","enabled":true,"tokenize":"trigram","weights":{"title":10,"content":1}}'
トークナイザを変えると、そのコレクションの索引は作り直されます。記事側は触りません。既存サイトに後から入れる場合でも、原稿の修正は発生しない。
前提として、コレクションの supports に search があり、拾わせたいフィールドに searchable が立っている必要があります。自サイトはタイトル・要約・本文の3つを対象にしています。
{
  "slug": "blog_posts",
  "supports": ["drafts", "revisions", "search", "seo"],
  "fields": [
    { "slug": "title",   "type": "string",       "searchable": true },
    { "slug": "summary", "type": "text",         "searchable": true },
    { "slug": "content", "type": "portableText", "searchable": true }
  ]
}どのフィールドを検索に載せるかは、そのままヘッドレスCMSのフィールド設計の話につながります。本文のリッチテキスト1本に全部詰め込んでいると、検索対象を絞ることもできません。
trigram にも穴がある。2文字以下は当たらない
万能ではありません。SQLite の公式ドキュメントは、trigram について「3文字未満の部分文字列はどの行にも一致しない」と明記しています。3文字ずつで索引を作る仕組みなので、2文字では索引の単位に届かない。
日本語には2文字の語がふつうにあります。「経費」「人事」「予約」「求人」。BtoBサイトほど踏みやすい。
しかも、既定のままなら当たっていた短い語が、切り替えると落ちます。先ほどの自サイトで「フォ」の2文字を投げると19件返ってきた。trigram に替えると、これは0件になる。途中一致を取る代わりに短い語を捨てる、というトレードオフです。
穴はUI側で吸収します。
- 2文字以下が入力されたら「3文字以上で検索してください」と出す。0件の白い画面より親切
- サジェスト(
/_emdash/api/search/suggest)を併用し、打ち終わる前に候補を見せる - タグ・カテゴリの一覧導線を検索窓のそばに置く。短い語ほど、検索より一覧のほうが速い
形態素解析まで求めるなら外部の検索サービスという手もある。ただ記事数が数十から数百のサイトなら、trigram と導線の組み合わせで足りることが多いと感じています。
検索を付ける前に、決めておく3つ
実装を渡す前にここが決まっていると、そのまま組めます。
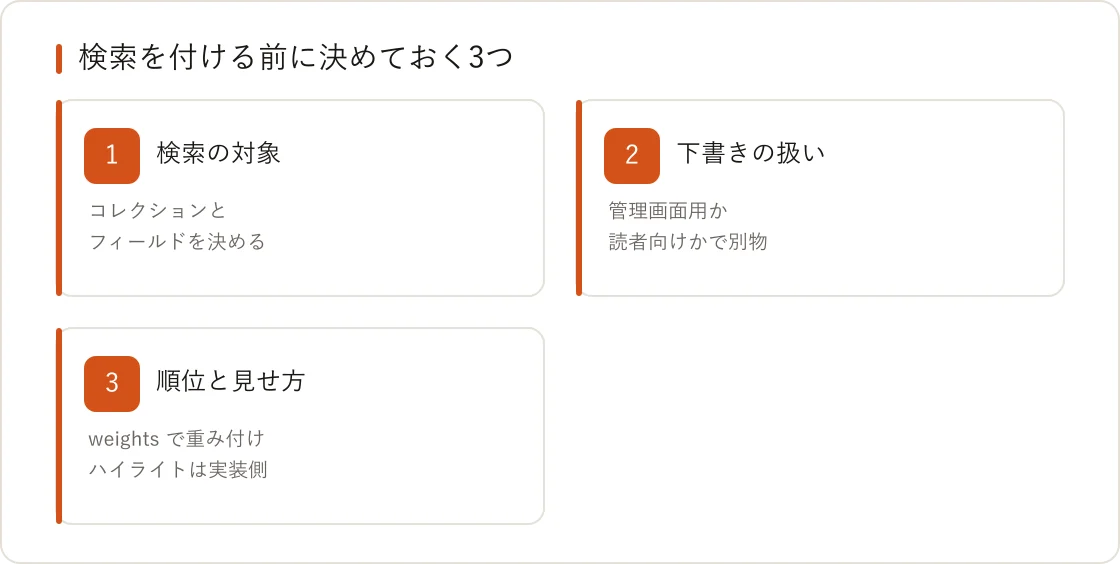
- 何を検索対象にするか。コレクションとフィールド。本文だけか、要約やタグも拾うか。対象を広げるほどノイズも増える
- 下書きを含めるか。EmDash の検索APIは既定で公開済みだけを返します。管理画面の中で探したいのか、公開サイトの読者に出したいのかで別物になる(下書きの扱いはヘッドレスCMSのプレビュー実装でも触れています)
- 順位と見せ方。
weightsでタイトルを本文より重くできる。マッチ箇所は<mark>タグ付きのスニペットで返るので、ハイライト表示は実装側で組む
「検索が当たらない」と言われたとき、記事の書き方やCMSの乗り換えを疑う前に、索引の切り方を見てください。設定ひとつで直る場合があります。
この手の切り分けと修正だけを切り出して頼みたい制作会社の方は、お問い合わせからご相談ください。既存サイトの改修・高速化も同じ入口で受けています。
※本記事は2026年8月時点の情報です。